Fine-tuning de un modelo de lenguaje de gran escala (LLM) solía requerir clusters de GPU de alto costo. QLoRA (Quantized Low-Rank Adaptation) cambió esa ecuación: permite ajustar modelos de hasta 70B de parámetros en una sola GPU de consumidor. Esta guía explica cómo funciona, cuándo usarlo y cómo ejecutarlo en proyectos empresariales reales.
¿Qué es QLoRA y por qué importa para empresas?
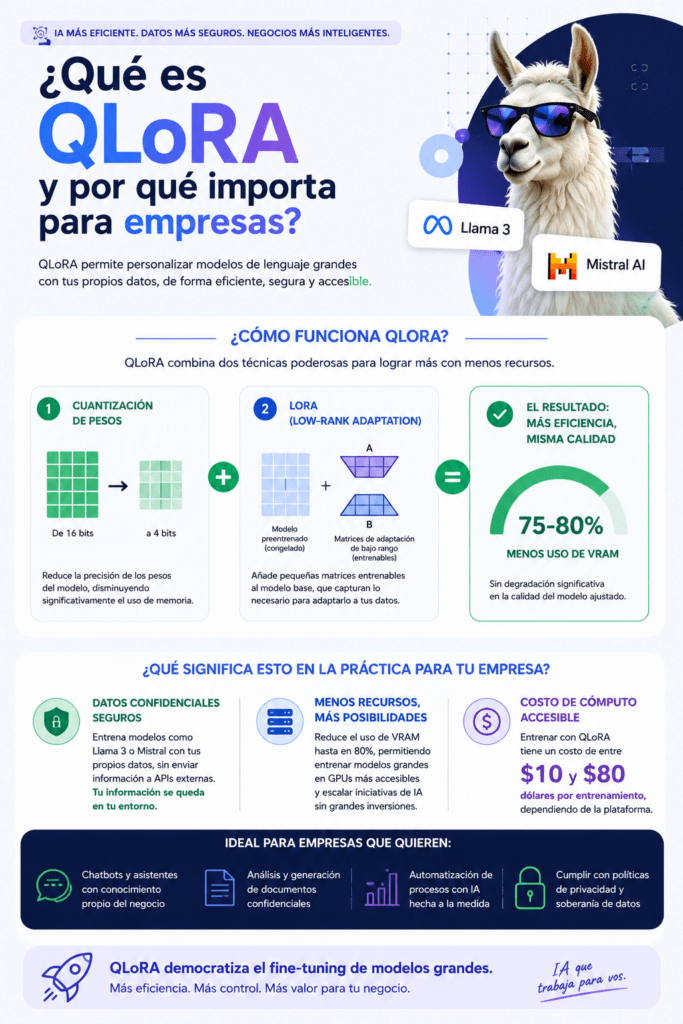
QLoRA combina dos técnicas: cuantización de pesos (reducir la precisión de los pesos del modelo de 16 a 4 bits) y LoRA (Low-Rank Adaptation, que añade matrices de adaptación de bajo rango al modelo base). El resultado es una técnica que reduce el uso de VRAM en un 75-80% sin degradación significativa de la calidad del modelo ajustado.
En la práctica, esto significa que una empresa puede personalizar un modelo como Llama 3 o Mistral sobre sus propios datos confidenciales sin enviar esa información a APIs externas, y con un costo de cómputo de entre 10 y 80 dólares por entrenamiento, dependiendo de la plataforma.
Diferencia entre LoRA y QLoRA
| Característica | LoRA | QLoRA |
| Precisión del modelo base | 16-bit (FP16/BF16) | 4-bit (NF4) |
| VRAM requerida (7B modelo) | ~14 GB | ~6 GB |
| VRAM requerida (13B modelo) | ~26 GB | ~10 GB |
| Velocidad de entrenamiento | Más rápida | Algo más lenta |
| Calidad del output | Alta | Alta (comparable) |
| Costo en GPU cloud | Medio-alto | Bajo |
Cuándo aplicar QLoRA en un proyecto empresarial
QLoRA es la técnica correcta cuando se cumplen estas condiciones:
- Los datos de entrenamiento son confidenciales y no pueden salir de la infraestructura de la empresa.
- El modelo base genérico no responde bien al vocabulario, jerga o formato esperado por el negocio.
- El presupuesto de infraestructura es limitado (menos de 500 USD por experimento).
- Se necesita un modelo especializado en una tarea específica: clasificación de tickets, generación de informes, Q&A sobre documentos internos.
Arquitectura técnica: cómo funciona internamente
El proceso de QLoRA tiene tres componentes centrales que el equipo técnico debe entender antes de implementar:
1. Cuantización NF4 (Normal Float 4-bit)
Los pesos del modelo base se comprimen a 4 bits usando el formato NF4, diseñado específicamente para distribuciones de pesos de LLMs (que son aproximadamente gaussianas). A diferencia de cuantizaciones enteras, NF4 preserva mejor la información en los extremos de la distribución.
2. Double quantization
Los propios coeficientes de cuantización se cuantizan de nuevo, ahorrando entre 0.37 y 0.5 bits adicionales por parámetro, lo que permite acomodar modelos aún más grandes en la misma GPU.
3. Matrices LoRA entrenables en BF16
Mientras el modelo base permanece congelado en 4 bits, las matrices de adaptación de bajo rango (LoRA) se entrenan en precisión BF16 completa. Solo estas matrices (que representan menos del 1% de los parámetros totales) se actualizan durante el entrenamiento.
Guía de implementación paso a paso
Paso 1: Preparar el dataset
El dataset debe estar en formato conversacional (instruction-tuning format). Cada ejemplo contiene tres campos: instruction (la tarea), input (el contexto opcional) y output (la respuesta esperada). El mínimo recomendado es 500 ejemplos de alta calidad; más de 2,000 ejemplos ofrece mejoras marginales para tareas específicas.
Paso 2: Seleccionar el modelo base
Para la mayoría de casos empresariales en español, los candidatos más efectivos en 2025 son Llama 3.1 8B (Meta), Mistral 7B v0.3 y Qwen 2.5 7B (especialmente para idiomas de LATAM y textos financieros).
Paso 3: Configurar parámetros de entrenamiento
| Parámetro | Valor recomendado | Descripción |
| r (rango LoRA) | 16 — 64 | Capacidad de adaptación. Mayor rango = más parámetros entrenables |
| lora_alpha | 32 — 128 | Factor de escala. Regla empírica: 2x el valor de r |
| lora_dropout | 0.05 — 0.1 | Regularización para evitar sobreajuste |
| learning_rate | 2e-4 | Tasa de aprendizaje estándar para fine-tuning con LoRA |
| batch_size | 4 — 16 | Ajustar según VRAM disponible |
| num_epochs | 2 — 5 | Más épocas aumentan riesgo de overfitting |
| max_seq_length | 2048 | Longitud máxima del contexto de cada ejemplo |
Paso 4: Entrenamiento y monitoreo
Durante el entrenamiento, las métricas clave a monitorear son: training loss (debe decrecer de forma estable), validation loss (si sube mientras training loss baja, hay overfitting) y gradient norm (valores extremadamente altos indican inestabilidad en el aprendizaje).
Paso 5: Evaluación y merging
Una vez entrenado, el adaptador LoRA se fusiona con el modelo base para generar un modelo completo independiente. La evaluación debe hacerse con ejemplos que el modelo no vio durante el entrenamiento y, cuando sea posible, con evaluadores humanos del dominio de negocio.
Errores más comunes en proyectos QLoRA empresariales
- Dataset de baja calidad: 200 ejemplos de alta calidad superan a 5,000 ejemplos ruidosos.
- Rango LoRA excesivo: r=256 raramente supera a r=64 en tareas especializadas y sí aumenta el costo.
- No usar validación separada: sin validation set, el modelo puede sobreajustarse sin que el equipo lo detecte.
- Ignorar la cuantización del output: el modelo fusionado debe re-cuantizarse para inferencia eficiente en producción.
Caso real: fine-tuning para procesamiento de documentos financieros
En un proyecto de consultoría ejecutado con un banco peruano de primer nivel, se aplicó QLoRA sobre Mistral 7B para clasificar y resumir contratos de crédito. El dataset consistió en 1,200 contratos anonimizados. El entrenamiento tomó 4 horas en una instancia A100 de Google Cloud (costo aproximado: 28 USD). El modelo resultante superó en un 34% al modelo base en la tarea de extracción de cláusulas clave, sin que ningún dato saliera del entorno bancario.
Fuentes y referencias
- Dettmers, T. et al. (2023). QLoRA: Efficient Finetuning of Quantized LLMs. arXiv:2305.14314.
- Hu, E. et al. (2021). LoRA: Low-Rank Adaptation of Large Language Models. arXiv:2106.09685.
- Hugging Face PEFT Library Documentation (2025). huggingface.co/docs/peft
- Meta AI Research. (2024). Llama 3 Technical Report. ai.meta.com