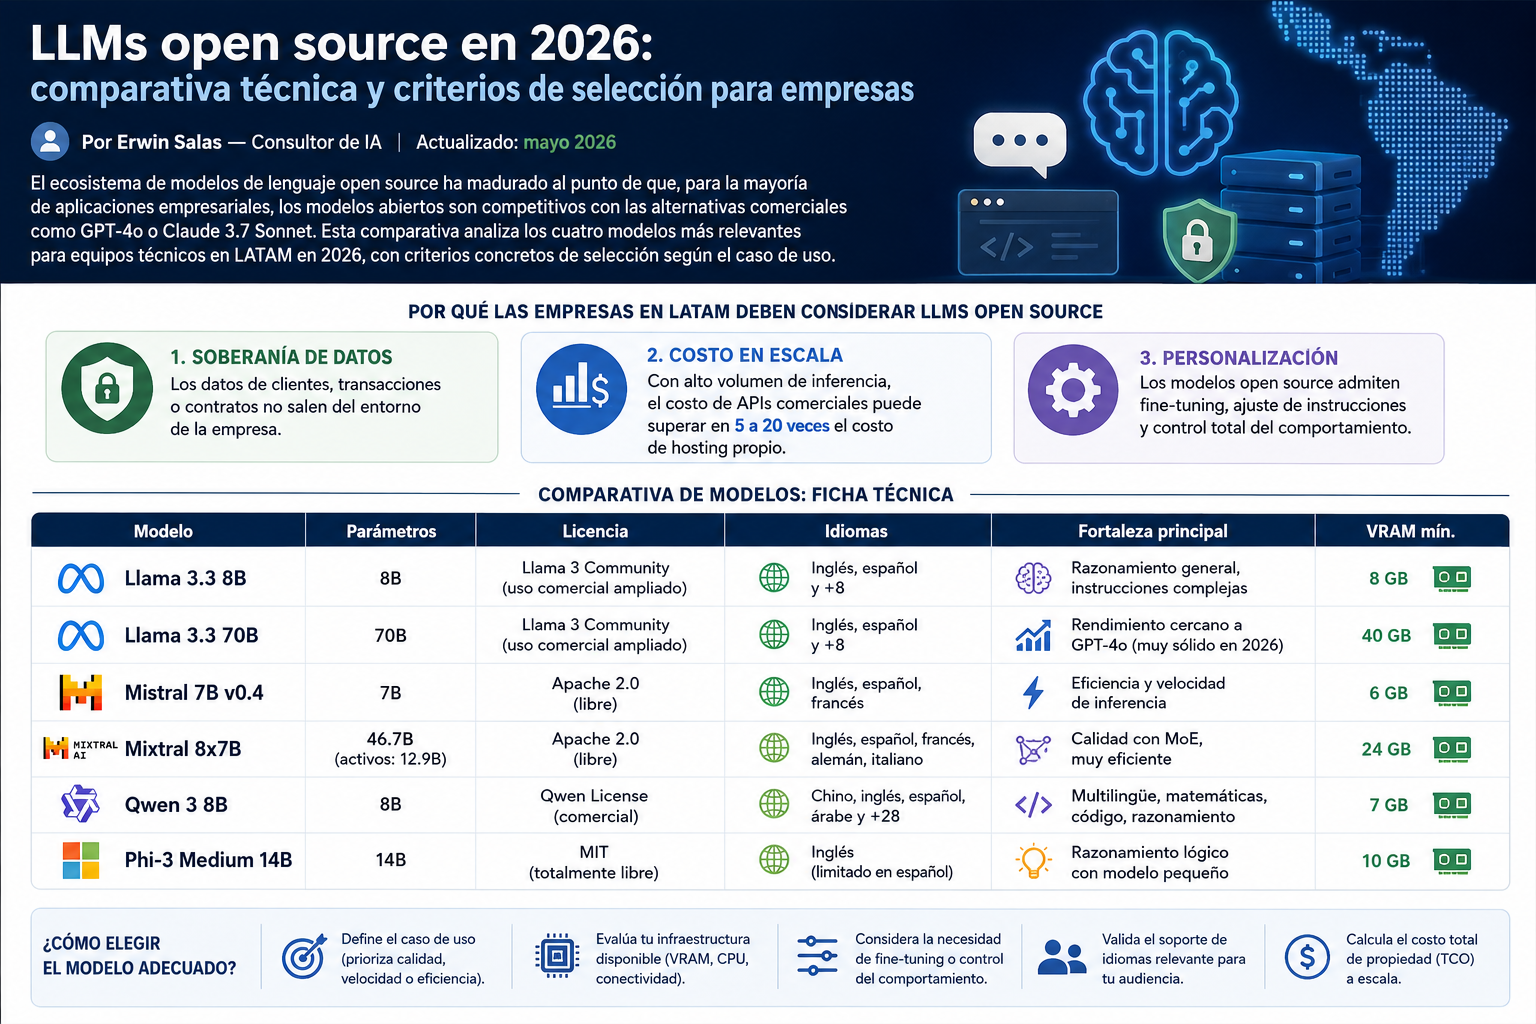
El ecosistema de modelos de lenguaje open source ha madurado al punto de que, para la mayoría de aplicaciones empresariales, los modelos abiertos son competitivos con las alternativas comerciales como GPT-4o o Claude 3.7 Sonnet. Esta comparativa analiza los cuatro modelos más relevantes para equipos técnicos en LATAM en 2026, con criterios concretos de selección según el caso de uso.
Contenidos
- 1. Por qué las empresas en LATAM deben considerar LLMs open source
- 2. Comparativa de modelos: ficha técnica
- 3. Análisis por caso de uso empresarial
- 4. Benchmarks de rendimiento: qué miden y cómo interpretarlos
- 5. Criterios de selección: árbol de decisión
- 6. Infraestructura de despliegue en 2026
- 7. Fuentes
Por qué las empresas en LATAM deben considerar LLMs open source
Tres razones prácticas justifican la evaluación de modelos open source frente a APIs comerciales en el contexto empresarial latinoamericano:
- Soberanía de datos: los datos de clientes, transacciones o contratos no salen del entorno de la empresa.
- Costo en escala: con alto volumen de inferencia, el costo de APIs comerciales puede superar en 5 a 20 veces el costo de hosting propio.
- Personalización: los modelos open source admiten fine-tuning, ajuste de instrucciones y control total del comportamiento.
Comparativa de modelos: ficha técnica
| Modelo | Parámetros | Licencia | Idiomas | Fortaleza principal | VRAM mín. |
| Llama 3.3 8B | 8B | Llama 3 Community (uso comercial ampliado) | Inglés, español y +8 | Razonamiento general, instrucciones complejas | 8 GB |
| Llama 3.3 70B | 70B | Llama 3 Community (uso comercial ampliado) | Inglés, español y +8 | Rendimiento cercano a GPT-4o (muy sólido en 2026) | 40 GB |
| Mistral 7B v0.4 | 7B | Apache 2.0 (libre) | Inglés, español, francés | Eficiencia y velocidad de inferencia | 6 GB |
| Mixtral 8x7B | 46.7B activos: 12.9B | Apache 2.0 (libre) | Inglés, español, francés, alemán, italiano | Calidad con MoE, muy eficiente | 24 GB |
| Qwen 3 8B | 8B | Qwen License (comercial) | Chino, inglés, español, árabe y +28 | Multilingüe, matemáticas, código, razonamiento | 7 GB |
| Phi-3 Medium 14B | 14B | MIT (totalmente libre) | Inglés (limitado en español) | Razonamiento lógico con modelo pequeño | 10 GB |
Análisis por caso de uso empresarial
Atención al cliente y chatbots en español
Para este caso, Llama 3.3 8B y Qwen 3 8B son los candidatos más fuertes. Ambos manejan bien el español latinoamericano, incluyendo variantes regionales. Qwen 2.5 supera a Llama en tareas con mezcla de idiomas o con inputs que combinan español e inglés técnico.
Análisis y extracción de documentos
Mixtral 8x7B y Llama 3.3 70B lideran en comprensión de documentos largos y extracción estructurada. Para equipos con recursos limitados, Mistral 7B con fine-tuning específico puede alcanzar rendimiento comparable en dominios bien delimitados.
Generación de código y automatización
Phi-3 Medium 14B destaca aquí de forma inesperada: a pesar de ser significativamente más pequeño que Llama 70B, su rendimiento en benchmarks de código (HumanEval, MBPP) es competitivo. Su licencia MIT lo hace ideal para productos SaaS sin restricciones de distribución.
Aplicaciones financieras y legales
Para aplicaciones con alta sensibilidad regulatoria, Llama 3.3 con fine-tuning sobre documentación financiera local es la ruta más segura. La licencia Llama 3 Community (uso comercial ampliado) permite uso comercial con restricciones en escala de usuarios, por lo que equipos legales deben revisar los términos antes del despliegue.
Benchmarks de rendimiento: qué miden y cómo interpretarlos
| Benchmark | Qué mide | Líder (open source) |
| MMLU | Conocimiento general (57 materias) | Llama 3.3 70B |
| HumanEval | Generación de código Python | Phi-3 Medium |
| MT-Bench | Conversación multiturn y razonamiento | Mixtral 8x7B |
| HellaSwag | Comprensión de sentido común | Llama 3.3 70B |
| TruthfulQA | Reducción de alucinaciones | Mistral 7B (fine-tuned) |
| MGSM (español) | Matemáticas en español | Qwen 3 8B |
Importante: los benchmarks miden rendimiento en condiciones controladas. En producción, la calidad depende fuertemente del prompt, del contexto y del nivel de especialización del modelo en el dominio. Un modelo con menor benchmark pero fine-tuning específico puede superar a uno con mayor benchmark en la tarea concreta.
Criterios de selección: árbol de decisión
- ¿Los datos son altamente confidenciales? → Modelos open source en infraestructura propia.
- ¿El presupuesto de cómputo es limitado? → Modelos de 7-8B con fine-tuning (Llama 3.3 8B o Qwen 3 8B).
- ¿Se requiere máxima calidad sin restricciones de VRAM? → Llama 3.3 70B o Mixtral 8x7B.
- ¿El caso implica generación de código o agentes? → Phi-3 Medium o Llama 3.3 8B con herramientas de function calling.
- ¿Se necesita distribución como producto (SaaS)? → Modelos con licencia Apache 2.0 o MIT (Mistral, Phi-3).
Infraestructura de despliegue en 2026
Las opciones de despliegue más utilizadas para LLMs open source en entornos empresariales en 2026 son: Ollama (local, muy maduro, soporta cuantización GGUF nativa), vLLM (producción, alto throughput, el estándar de facto para inferencia en batch), LiteLLM (capa de abstracción para cambiar de modelo sin reescribir integraciones), Hugging Face Inference Endpoints (cloud gestionado) y llama.cpp (inferencia en CPU para entornos sin GPU disponible).
Fuentes
- Hugging Face Open LLM Leaderboard (2026). huggingface.co/spaces/open-llm-leaderboard/about
- Meta AI. (2024). Llama 3 Model Card. ai.meta.com/llama
- Mistral AI. (2024). Mixtral of Experts. arxiv.org/abs/2401.04088
- Microsoft Research. (2024). Phi-3 Technical Report. arxiv.org/abs/2404.14219