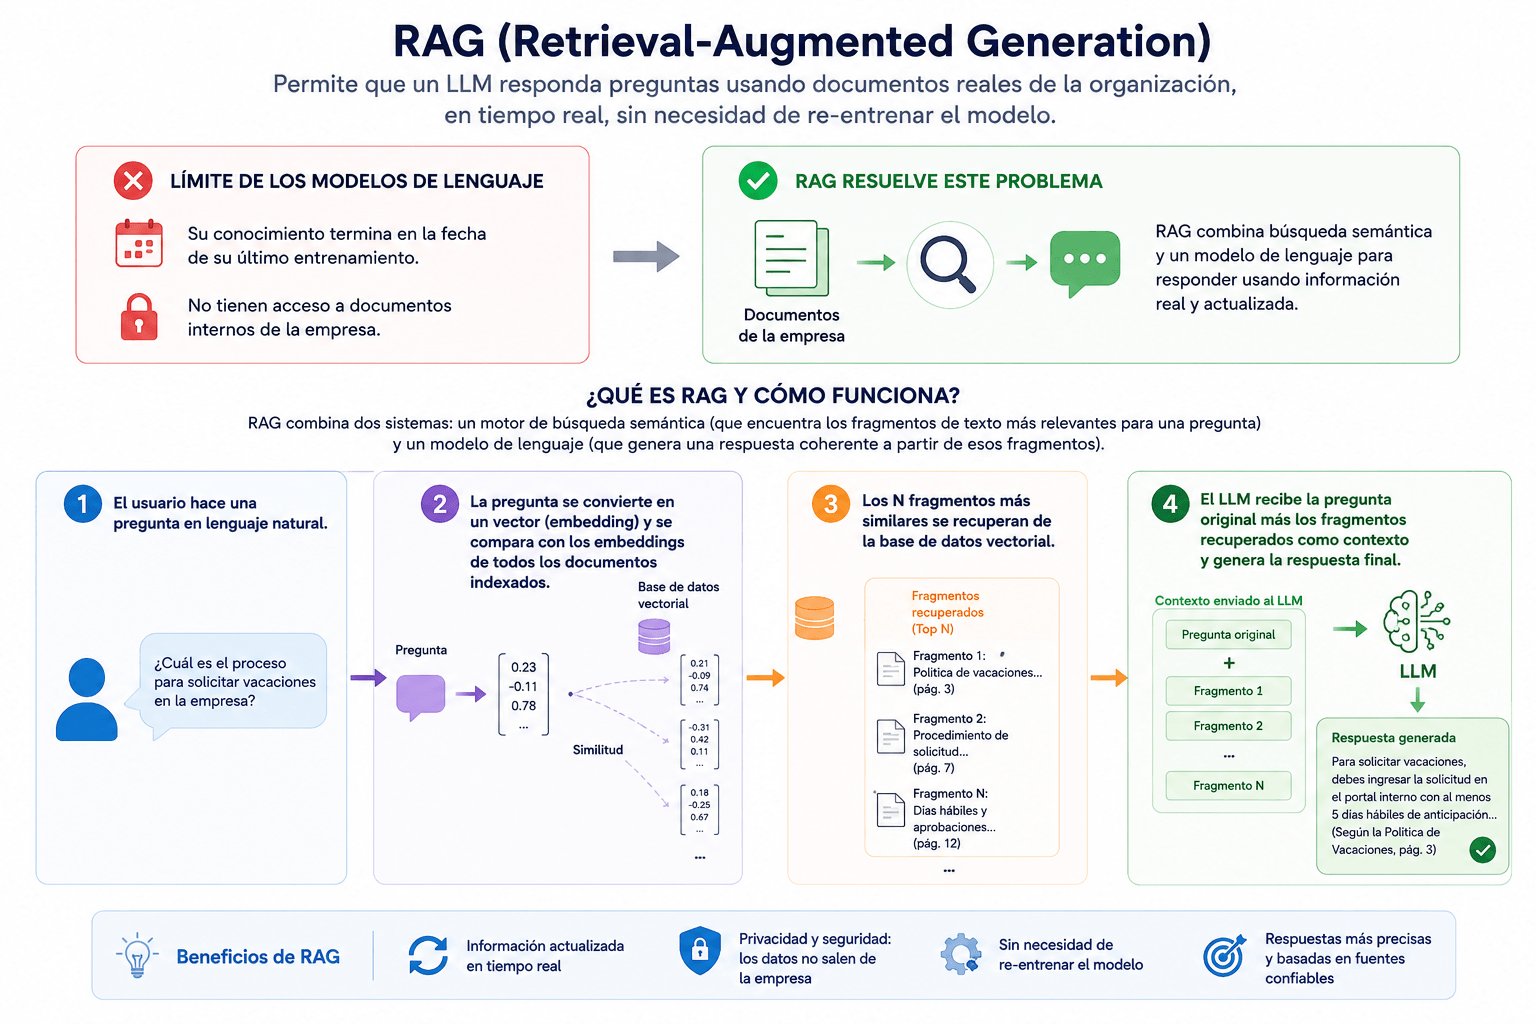
Los modelos de lenguaje tienen un límite conocido: su conocimiento termina en la fecha de su último entrenamiento y no tienen acceso a documentos internos de la empresa. RAG (Retrieval-Augmented Generation) resuelve exactamente ese problema: permite que un LLM responda preguntas usando documentos reales de la organización, en tiempo real, sin necesidad de re-entrenar el modelo.
Contenidos
Qué es RAG y cómo funciona
RAG combina dos sistemas: un motor de búsqueda semántica (que encuentra los fragmentos de texto más relevantes para una pregunta) y un modelo de lenguaje (que genera una respuesta coherente a partir de esos fragmentos). El proceso completo tiene cuatro pasos:
- El usuario hace una pregunta en lenguaje natural.
- La pregunta se convierte en un vector (embedding) y se compara con los embeddings de todos los documentos indexados.
- Los N fragmentos más similares se recuperan de la base de datos vectorial.
- El LLM recibe la pregunta original más los fragmentos recuperados como contexto y genera la respuesta final.
Cuándo RAG es la solución correcta
| Situación | ¿RAG es la solución? |
| El equipo necesita consultar manuales, políticas o contratos internos | Sí — caso ideal para RAG |
| Se requiere que el modelo aprenda un estilo de escritura propio | No — usar fine-tuning |
| La información cambia frecuentemente (precios, stock, noticias) | Sí — RAG actualiza el índice fácilmente |
| Se necesita razonamiento sobre datos estructurados (tablas, bases de datos) | Parcialmente — combinar con SQL Agent |
| El corpus documental supera 10 millones de tokens | Sí — RAG escala mejor que context window largo |
Arquitectura de referencia: RAG en producción
Componente 1: Ingesta de documentos
Los documentos (PDFs, Word, HTML, correos) se procesan con parsers especializados. El texto se divide en chunks de entre 256 y 1024 tokens con solapamiento de 10-20% para preservar contexto entre fragmentos. Cada chunk se enriquece con metadatos (fuente, fecha, departamento) que permiten filtrado posterior.
Componente 2: Base de datos vectorial
Los chunks se convierten en vectores usando un modelo de embedding. Las opciones más usadas en entornos empresariales son: ChromaDB (local, ideal para pruebas), Pinecone (cloud gestionado, alta escala), Weaviate (open source, auto-alojado) y pgvector (extensión de PostgreSQL, ideal si la empresa ya usa Postgres).
Componente 3: Pipeline de recuperación
La recuperación puede ser densa (solo embeddings), híbrida (embeddings más BM25 por palabras clave) o con re-ranking (un segundo modelo reordena los resultados por relevancia). El pipeline híbrido con re-ranking ofrece la mejor calidad para documentos empresariales en español.
Componente 4: Generación aumentada
El LLM recibe un prompt estructurado que incluye instrucciones de comportamiento, los fragmentos recuperados con sus fuentes y la pregunta del usuario. La respuesta debe incluir siempre las referencias a los documentos fuente para mantener trazabilidad.
Herramientas y stack recomendado para empresas en LATAM
| Componente | Opción económica | Opción enterprise |
| Parsing de documentos | PyMuPDF + Docling (2026) | Azure Document Intelligence v4 |
| Embeddings | multilingual-e5-large o nomic-embed (gratis) | OpenAI text-embedding-3-large |
| Vector DB | ChromaDB o pgvector | Pinecone o Weaviate Cloud |
| LLM para generación | Llama 3.3 8B local | GPT-4o, Claude 3.7 Sonnet o Gemini 2.0 Flash |
| Orquestación | LangChain 0.3 o LlamaIndex 0.11 | LangGraph para flujos complejos (2026) |
| Interfaz de usuario | Chainlit o Streamlit | Aplicación custom con FastAPI |
Implementación en 5 semanas: plan de proyecto
Semana 1: Diagnóstico y definición del corpus
Identificar los documentos que el sistema debe conocer, definir casos de uso prioritarios (¿quién usa el sistema, qué preguntas hace?) y establecer métricas de éxito antes de escribir la primera línea de código.
Semana 2: Ingesta y chunking
Configurar el pipeline de ingesta, procesar el corpus inicial y validar la calidad del chunking con revisión manual de una muestra de 50 fragmentos.
Semana 3: Recuperación y evaluación
Construir el índice vectorial, implementar la recuperación y medir la precisión con un set de 30-50 preguntas conocidas (donde se sabe qué documento contiene la respuesta correcta).
Semana 4: Generación y ajuste de prompts
Integrar el LLM, ajustar el prompt del sistema para el tono y formato esperado, y comenzar pruebas con usuarios internos reales.
Semana 5: Despliegue y monitoreo
Lanzar en producción con logging de todas las consultas y respuestas, implementar feedback de usuarios (pulgares arriba/abajo) y establecer revisión semanal de las respuestas con menor puntuación.
Caso real: RAG para consultas sobre normativa interna
En un proyecto de 6 semanas ejecutado en 2025 con una institución financiera regulada, se implementó RAG sobre un corpus de 1,200 documentos de normativa interna, circulares SBS y manuales de procedimiento. El sistema respondió correctamente el 93% de las consultas de prueba con trazabilidad completa a la fuente (pipeline híbrido con re-ranking). El tiempo de respuesta a consultas regulatorias pasó de 48 horas de búsqueda manual a menos de 25 segundos.
Fuentes
- Lewis, P. et al. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. arXiv:2005.11401.
- Gao, Y. et al. (2023-2024). Retrieval-Augmented Generation for Large Language Models: A Survey (v3). arXiv:2312.10997. [Ampliamente citado; más de 3,000 citas académicas a mayo 2026]
- LangChain Documentation. (2026). RAG from Scratch. python.langchain.com