Contenidos
- 1. Guía Completa: Ecosistema Hugging Face 2026
- 2. 1. Arquitectura del Ecosistema Hugging Face
- 3. 2. El Hub en Profundidad
- 4. 3. Model Cards: Evaluando Modelos
- 5. 4. Pipelines: La Abstracción de Alto Nivel
- 6. 5. Modelos Especializados
- 7. 6. La Librería Datasets
- 8. 7. Spaces: Demos y Aplicaciones
- 9. 8. Flujo de Trabajo Integrado
- 10. 9. Puntos Clave para Recordar
Guía Completa: Ecosistema Hugging Face 2026
1. Arquitectura del Ecosistema Hugging Face
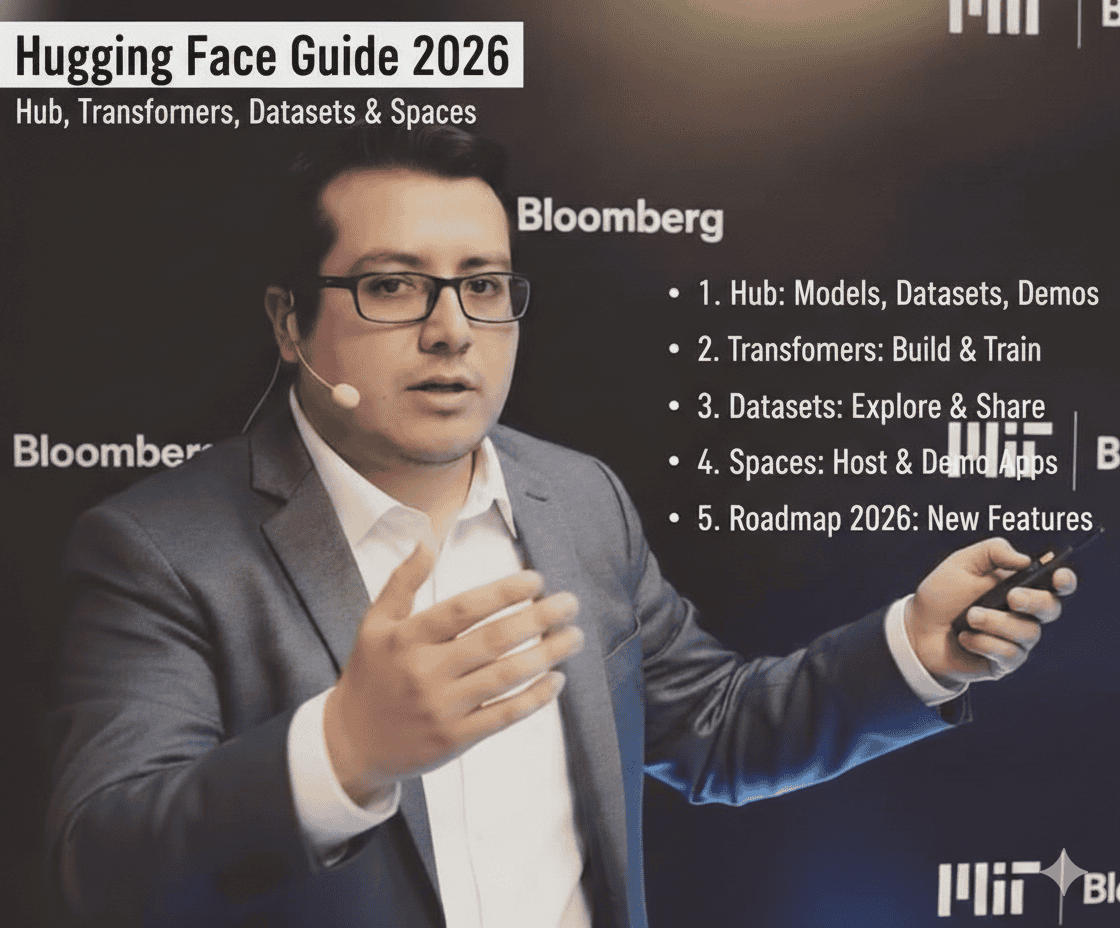
Hugging Face comenzó como una startup de chatbots y pivoteó a convertirse en el «GitHub de Machine Learning». Entender su arquitectura es fundamental porque es donde vive la mayoría del ecosistema open source de LLMs.
1.1 Los Cuatro Pilares
Piensa en Hugging Face como una plataforma con cuatro componentes interconectados.
Hugging Face Hub es el repositorio central, como un GitHub especializado en ML. Aquí se almacenan modelos (más de 500,000), datasets (más de 100,000), y Spaces (aplicaciones). Cada recurso tiene versionamiento con Git, documentación estandarizada, y métricas de uso.
Transformers es la librería de Python que permite cargar y usar los modelos del Hub. Proporciona una interfaz unificada sin importar si el modelo es de Meta, Mistral, Google o la comunidad. La abstracción clave son los «pipelines» que simplifican tareas comunes.
Datasets es la librería para cargar, procesar y compartir conjuntos de datos. Está optimizada para manejar datos grandes sin cargarlos completamente en memoria (usa Apache Arrow). Incluye herramientas de preprocesamiento y filtrado.
Spaces es la plataforma de hosting para demos y aplicaciones. Soporta Gradio, Streamlit y Docker. Permite crear interfaces interactivas sin infraestructura propia, ideal para demos a clientes o prototipos internos.
1.2 Cómo Se Conectan
El flujo típico funciona así: Encuentras un modelo en el Hub, lo cargas con Transformers, lo entrenas o evalúas con datos de Datasets, y creas una demo en Spaces. Todo está integrado con una sola autenticación y el mismo CLI.
2. El Hub en Profundidad
2.1 Estructura de un Repositorio de Modelo
Cada modelo en el Hub es un repositorio Git con una estructura específica. Contiene archivos de pesos del modelo (safetensors o pytorch_model.bin), archivos de configuración (config.json, tokenizer.json), el README.md que es el Model Card, y opcionalmente scripts de entrenamiento y ejemplos.
2.2 Navegando el Hub Efectivamente
Cuando buscas modelos, los filtros más útiles son por tarea (text-generation, text-classification), por librería (transformers, sentence-transformers), por idioma, y por licencia (apache-2.0, mit para uso comercial).
Las métricas a observar incluyen descargas mensuales que indican adopción, likes que muestran validación de la comunidad, y la fecha de actualización que indica mantenimiento activo.
2.3 Ejemplo Práctico de Búsqueda
Si necesitas un modelo para clasificación de texto en español con licencia comercial, irías a huggingface.co/models, filtrarías por Task: Text Classification, Language: Spanish, y License: apache-2.0 o mit. Luego ordenarías por descargas para ver los más usados.
3. Model Cards: Evaluando Modelos
3.1 ¿Qué es un Model Card?
Un Model Card es documentación estandarizada que describe un modelo. Fue propuesto por Google en 2018 como práctica de ML responsable. Es el README.md del repositorio pero con secciones específicas.
3.2 Secciones Críticas a Evaluar
Model Description te dice qué hace el modelo, quién lo creó, y para qué fue diseñado. Aquí verificas si el propósito original coincide con tu caso de uso.
Training Data describe con qué datos se entrenó. Es crucial para entender sesgos potenciales y dominios donde funcionará bien. Un modelo entrenado solo con Wikipedia tendrá diferente comportamiento que uno entrenado con conversaciones.
Evaluation muestra métricas de rendimiento en benchmarks estándar. Busca métricas relevantes para tu tarea: perplexity para generación, F1 para clasificación, BLEU para traducción.
Limitations and Biases documenta honestamente dónde falla el modelo. Esta sección te ahorra tiempo de descubrir limitaciones por ti mismo.
How to Use proporciona código de ejemplo para cargar y usar el modelo. Copia y adapta este código como punto de partida.
3.3 Banderas Rojas en Model Cards
Desconfía cuando no hay Model Card o está vacío, cuando no hay información de datos de entrenamiento, cuando las métricas de evaluación son vagas o ausentes, cuando la licencia no está clara, o cuando no hay ejemplos de código funcionales.
3.4 Evaluación Práctica de Modelos
Más allá del Model Card, evalúa con tus propios datos. Los benchmarks públicos no reflejan tu caso de uso específico. Un modelo con peor score general puede funcionar mejor en tu dominio.
4. Pipelines: La Abstracción de Alto Nivel
4.1 ¿Qué son los Pipelines?
Los pipelines son la forma más simple de usar modelos en Transformers. Abstraen tokenización, inferencia y post-procesamiento en una sola llamada. Son ideales para prototipado rápido y casos de uso estándar.
4.2 Pipelines Disponibles
Para procesamiento de texto tienes text-generation para completar texto o chat, text-classification para categorizar texto, question-answering para responder preguntas sobre un contexto, summarization para resumir textos largos, translation para traducir entre idiomas, fill-mask para completar palabras faltantes, y ner para identificar entidades nombradas.
Para otros tipos de datos hay image-classification, object-detection, automatic-speech-recognition, y text-to-image.
4.3 Anatomía de un Pipeline
Cuando creas un pipeline sucede lo siguiente internamente: se descarga el modelo del Hub si no está en caché, se carga el tokenizador apropiado, se configura el modelo para inferencia, y se prepara el post-procesador para formatear salidas.
Cuando ejecutas el pipeline sobre un texto, primero tokeniza convirtiendo texto a IDs numéricos, luego ejecuta el forward pass a través del modelo, después decodifica los tokens de salida a texto, y finalmente aplica formateo específico de la tarea.
4.4 Cuándo Usar Pipelines vs Código Manual
Usa pipelines cuando estés prototipando rápidamente, cuando la tarea sea estándar sin customización, cuando quieras código limpio y mantenible, o para demos y pruebas de concepto.
Usa código manual cuando necesites control sobre tokenización, cuando quieras batch processing optimizado, cuando implementes lógica de generación custom, o para fine-tuning y entrenamiento.
5. Modelos Especializados
5.1 Modelos para Español
BETO y derivados: BETO fue el primer BERT entrenado específicamente en español, creado por la Universidad de Chile. Tiene variantes como BETO-cased y BETO-uncased, y es bueno para clasificación, NER, y embeddings. Sus limitaciones son que está basado en arquitectura antigua (BERT) y tiene contexto limitado (512 tokens).
MarIA: Fue desarrollado por el Barcelona Supercomputing Center, entrenado en corpus masivo de español (570GB de texto). Tiene variantes para diferentes tareas y es más moderno que BETO con mejor rendimiento.
Modelos multilingües optimizados: Los más relevantes incluyen mBERT que es BERT entrenado en 104 idiomas, XLM-RoBERTa que tiene mejor rendimiento multilingüe que mBERT, y los modelos Qwen que tienen el mejor tokenizador para español entre los LLMs grandes.
5.2 Modelos para Finanzas
FinBERT: Fue creado por Prosus AI, entrenado en comunicaciones financieras como reportes 10-K, earnings calls, y noticias. Está especializado en análisis de sentimiento financiero y es el estándar de facto para NLP financiero en inglés.
FinGPT: Es un proyecto open source de LLM financiero, más reciente que FinBERT, con capacidades generativas.
Consideraciones para español financiero: No existe un «FinBERT español» establecido. Las opciones son fine-tunear modelos españoles con datos financieros locales, usar modelos multilingües que capturan terminología financiera, o crear embeddings especializados con datos de SBS, SMV, y noticias financieras peruanas.
5.3 Sentence Transformers para Embeddings
Esta es una librería especializada para crear embeddings de oraciones, esencial para búsqueda semántica y RAG. Los modelos recomendados para español incluyen paraphrase-multilingual-MiniLM-L12-v2 que es rápido y bueno para español, multilingual-e5-large que tiene mejor calidad pero es más lento, y sentence-transformers/LaBSE que es el mejor para idiomas diversos.
6. La Librería Datasets
6.1 Conceptos Clave
Datasets usa Apache Arrow para almacenamiento eficiente en disco, lo que permite trabajar con datos más grandes que la RAM mediante memory mapping, hacer streaming de datasets enormes sin descarga completa, y procesar en paralelo con múltiples CPUs.
6.2 Operaciones Comunes
Las operaciones más frecuentes son cargar datasets del Hub o locales, filtrar por condiciones, mapear funciones sobre todos los ejemplos, dividir en train/test/validation, y guardar en diferentes formatos.
6.3 Datasets Relevantes para tu Contexto
Para tareas en español están XNLI (inferencia en múltiples idiomas), MLQA (question answering multilingüe), Spanish Wikipedia (corpus general), y MASSIVE (intenciones multilingües de Amazon).
Para finanzas están financial_phrasebank (sentimiento financiero en inglés), SEC filings datasets, y news headlines datasets.
7. Spaces: Demos y Aplicaciones
7.1 Tipos de Spaces
Gradio es ideal para demos de ML con componentes predefinidos. Tiene la menor curva de aprendizaje y es perfecto para mostrar modelos a stakeholders no técnicos.
Streamlit ofrece más flexibilidad para dashboards y aplicaciones de datos, mejor para visualizaciones complejas, y requiere algo más de código.
Docker proporciona control total con cualquier framework, necesario para aplicaciones complejas o APIs, y requiere conocimiento de containerización.
7.2 Casos de Uso en Contexto Corporativo
Para demos a gerencia puedes crear un Space con Gradio que muestre el clasificador de intenciones, permitiendo que stakeholders prueben con frases reales sin tocar código.
Para prototipos internos puedes desplegar un Space privado con autenticación, útil para que el equipo pruebe iteraciones del modelo.
Para APIs internas puedes usar Docker Space como endpoint para otros sistemas, integrable con flujos existentes vía HTTP.
7.3 Limitaciones de Spaces Gratuitos
Los recursos son limitados (2 vCPU, 16GB RAM), se apagan después de inactividad, no tienen GPU en tier gratuito, y los modelos grandes no cargan. Para producción necesitas Spaces con GPU dedicada o infraestructura propia.
8. Flujo de Trabajo Integrado
8.1 El Ciclo Completo
Un proyecto típico sigue este flujo: Exploración en el Hub buscando modelos candidatos y datasets relevantes, luego Prototipado con Pipelines para pruebas rápidas con código mínimo, seguido de Evaluación con Datasets comparando modelos con tus datos, después Customización con Transformers para fine-tuning si es necesario, y finalmente Demo en Spaces creando interfaz para validación con usuarios.
8.2 Ejemplo Concreto: Clasificador de Intenciones
Para un proyecto de clasificador de intenciones, en el Hub buscarías modelos de text-classification en español. Con Pipelines harías pruebas rápidas con diferentes modelos. Con Datasets prepararías tu dataset de ejemplos etiquetados. Con Transformers harías fine-tuning del modelo elegido. Y en Spaces crearías demo para que el equipo de cobranzas valide.
9. Puntos Clave para Recordar
Sobre el Hub: Es el punto de partida para cualquier proyecto de NLP. Siempre verifica licencia, Model Card, y métricas antes de comprometerte con un modelo.
Sobre Pipelines: Son tu mejor amigo para prototipado. No reinventes la rueda, empieza simple y complejiza solo si es necesario.
Sobre Modelos en Español: El ecosistema ha mejorado mucho. Para clasificación y embeddings hay buenas opciones. Para generación, los modelos multilingües como Qwen son la mejor opción actualmente.
Sobre Finanzas: No existe el «modelo perfecto» para español financiero. La estrategia ganadora es combinar modelos base sólidos con fine-tuning en datos de tu dominio específico.
Sobre Spaces: Son excelentes para demos y validación. No los uses para producción con volumen alto, pero sí para alinear expectativas con stakeholders.
Siguiente capíutlo: Fine-Tuning de LLMs